

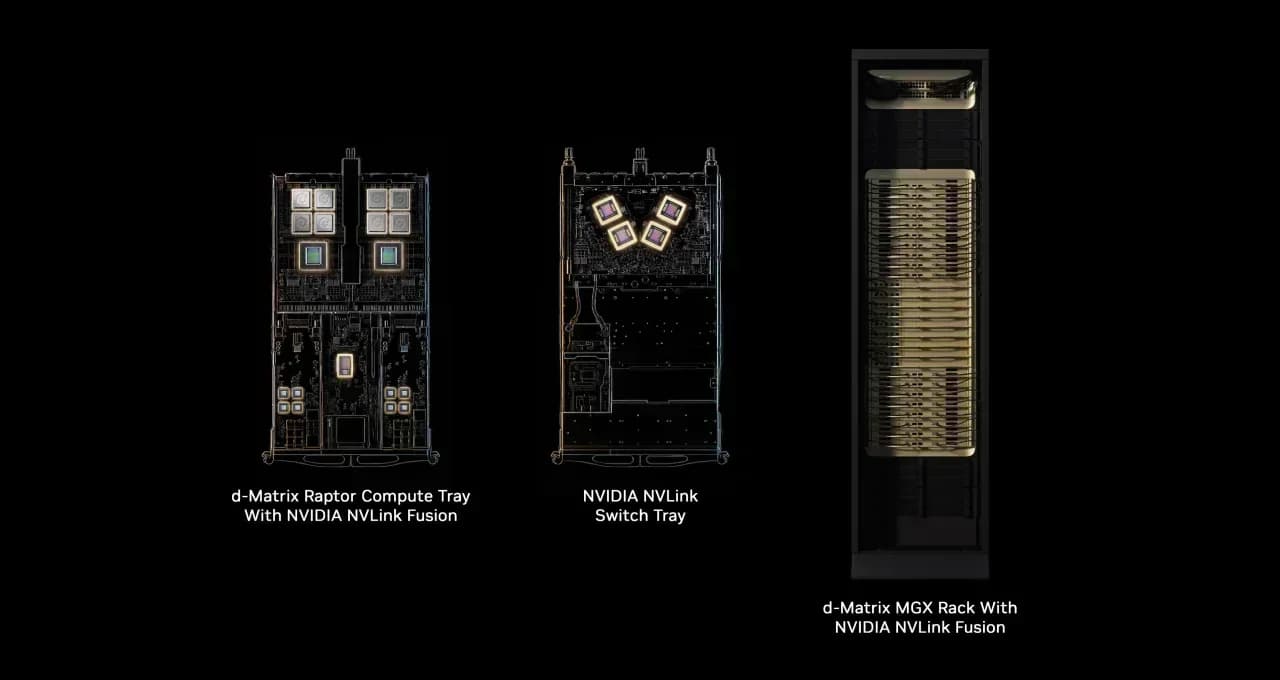
La alianza entre d-Matrix y NVIDIA es interesante porque no plantea sustituir las GPUs de NVIDIA, sino añadir otro tipo de acelerador dentro de su arquitectura de racks. La apuesta es que una infraestructura de IA pueda repartir diferentes fases de inferencia entre procesadores especializados y utilizar una misma base de sistema.
El primer hecho es la integración prevista. d-Matrix anunció que sus Raptor XPU se conectarán a la arquitectura de racks MGX mediante NVLink Fusion. El diseño de referencia incluye CPUs NVIDIA Vera, switches NVLink, DPUs BlueField-4, SuperNICs ConnectX-9 y redes Spectrum-X. Astera Labs participa además en soluciones de conectividad.
El segundo punto es el problema que Raptor intenta resolver. d-Matrix lo orienta a inferencia de baja latencia, donde unos milisegundos pueden afectar la experiencia de asistentes de programación, chatbots y agentes de voz. La empresa propone una arquitectura heterogénea: las GPUs pueden encargarse de fases intensivas como prefill y los XPUs de Raptor pueden acelerar el decode sensible a la latencia.
El tercer dato es que Raptor todavía no está disponible. d-Matrix espera completar el tape-out antes de que termine 2026 y sitúa la disponibilidad inicial de sistemas integrados en NVIDIA MGX en el cuarto trimestre de 2027. La empresa dice que hyperscalers y laboratorios de frontera están evaluando el acelerador, pero una evaluación no equivale a un despliegue comercial ni a una compra confirmada.
Raptor es una evolución de Corsair, plataforma de d-Matrix que ya está en producción. La compañía describe una arquitectura de memoria que coloca un chip DRAM y un chip de cómputo SRAM en un paquete de dos niveles mediante apilamiento 3D. La propuesta busca reducir la distancia entre memoria y cómputo para mejorar latencia y eficiencia.
La importancia de NVLink Fusion está en la barrera de adopción. Un acelerador especializado puede tener buenos resultados de laboratorio y, aun así, ser difícil de desplegar si necesita una infraestructura completamente distinta. Al entrar en el ecosistema MGX, d-Matrix intenta resolver una parte de ese problema utilizando racks, redes y cadena de suministro que los operadores de IA ya conocen.
Pero el anuncio todavía es una hoja de ruta. No hay resultados públicos de producción que demuestren que Raptor ofrece una ventaja económica suficiente frente a GPUs u otros aceleradores en cargas reales. Tampoco existe evidencia pública de adopción masiva.
Azutora ve dos escenarios. Si Raptor llega al rack en 2027 y demuestra mejoras medibles de latencia o costo, la colaboración puede servir como referencia para arquitecturas híbridas de inferencia. Si el calendario se retrasa o las evaluaciones no se convierten en despliegues, NVLink Fusion puede seguir siendo una plataforma de integración interesante sin que Raptor alcance escala comercial significativa.
La predicción, por ahora, debe quedarse cerca del calendario publicado: es razonable esperar disponibilidad inicial durante el cuarto trimestre de 2027, pero no hay base suficiente para anticipar un volumen de adopción mayor.